Modele AI a polskie prawo: wnioski z Benchmarku 02
W skrócie: Benchmark 02 objął 160 odpowiedzi ośmiu modeli AI — GPT, Claude i Gemini — na dziesięć pytań z polskiego prawa i pokazał rzecz, którą łatwo przeoczyć: to, że powołany przez model przepis istnieje, niewiele jeszcze mówi o jakości odpowiedzi. Wyniki opublikowaliśmy 29 października 2026 r. na stronie LawBenchmark.pl, a w tym wpisie omawiamy trzy przykłady z badania i ich znaczenie dla pracy prawnika.
Autor wpisu, r. pr. Adam Piotrowski, jest partnerem KTZR i współautorem benchmarku. Badanie prowadzi LexAlpha Lab, wspólna inicjatywa KTZR i spółki LexAlpha, która rozwija komercyjne narzędzia AI dla prawników; obie sfinansowały je ze środków własnych. Benchmark 02 nie obejmuje produktów żadnego z tych podmiotów, a żaden dostawca modeli nie uczestniczył w jego przygotowaniu. Pełna informacja o autorach i finansowaniu.
Pełne wyniki Benchmarku 02
Wyniki wszystkich ośmiu modeli, dziesięć pytań z kluczami, karty oceny 160 odpowiedzi i raport PDF.
Przejdź do LawBenchmark.plW tym artykule dowiesz się:
- jak często w badanej serii modele mylili się co do przepisów i orzeczeń,
- dlaczego sprawdzenie, czy przepis istnieje, nie wystarcza,
- co zmienia dostęp modelu do wyszukiwania w internecie,
- jak sprawdzać odpowiedź modelu, zanim trafi do pisma albo do klienta.
Jak badaliśmy modele AI na polskim prawie
Pytania pochodzą z praktyki kancelarii i mają postać, w jakiej prawnik wpisuje je do czatu — z literówkami i skrótami, a sześć z nich zawiera pułapkę, czyli błędne założenie albo kwestię aktualności prawa. Każdy z ośmiu modeli od trzech dostawców (OpenAI, Anthropic, Google) odpowiadał dwa razy: bez narzędzi i z dostępem do wyszukiwania zapewnianego przez dostawcę. Dla każdej odpowiedzi model oceniający przygotowywał wstępną kartę, którą następnie sprawdzał prawnik, a powołania przepisów i orzeczeń porównywaliśmy z tekstem urzędowym na dzień 1 października 2026 r. (sprawdzono 1 436 z 1 454). Pełne zasady oceny, łącznie z jawnie opisanymi zmianami dwóch kluczy po zebraniu odpowiedzi, są w metodologii.
Oceniamy dwie rzeczy, które łatwo pomylić. Halucynacja oznacza co najmniej jedno twierdzenie o przepisie lub orzeczeniu niezgodne z tekstem urzędowym, także wtedy, gdy sam wniosek jest trafny. Odpowiedź poprawnie ugruntowana zawiera wszystkie istotne elementy wskazane w kluczu, nie ma wykrytego błędu co do źródła prawa i ma co najmniej jedno powołanie potwierdzone przez oceniającego w źródle urzędowym.
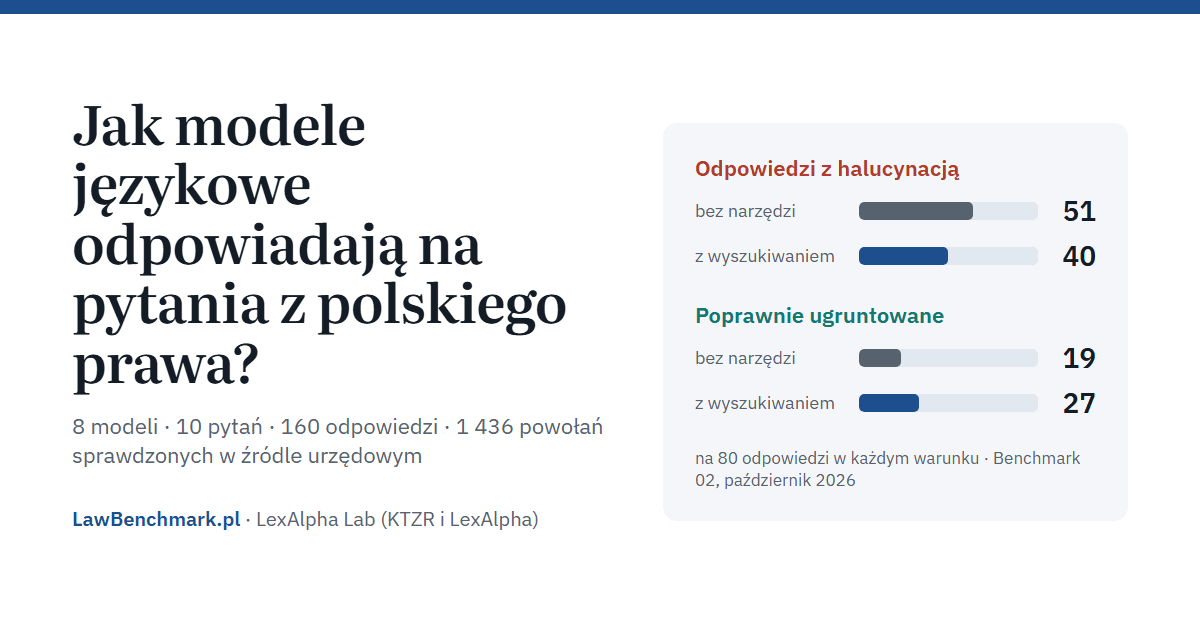
Bez narzędzi halucynację stwierdziliśmy w 51 odpowiedziach na 80, z wyszukiwaniem w 40, a poprawnie ugruntowanych było odpowiednio 19 i 27. Najwięcej odpowiedzi spełniających tę miarę uzyskały GPT-6.1 Sol i GPT-6 Astra (6 na 10 bez narzędzi i 7 na 10 z wyszukiwaniem), natomiast Claude Sonnet 5.5 i Claude Haiku 5.5 nie miały żadnej — co nie oznacza, że ich odpowiedzi nie zawierały trafnych informacji, tylko że żadna nie spełniła wszystkich warunków naraz. Wyniki wszystkich modeli trzeba czytać z zastrzeżeniem, które powtarzamy także na stronie benchmarku: dziesięć pytań, w tym pięć z postępowania cywilnego, jedna odpowiedź każdego modelu w każdym warunku i jeden sprawdzający prawnik nie pozwalają ustalić ogólnej skuteczności modeli ani ich rankingu.
Przepis istnieje, ale nie mówi tego, co twierdzi model
Halucynacja AI w prawie kojarzy się przede wszystkim ze zmyślonym wyrokiem, o czym pisaliśmy we wpisie Halucynacje AI w prawie: nie chodzi już o zmyślone wyroki, omawiając badania zagraniczne. W badanej serii nieistniejące źródło albo jednostkę redakcyjną oznaczyliśmy tylko w 4 odpowiedziach na 80 w każdym z warunków. Znacznie częściej, bo w 42 odpowiedziach bez narzędzi i w 24 z wyszukiwaniem, model powoływał istniejący przepis albo orzeczenie, przypisując mu treść, której w źródle nie ma.
Drugim co do częstości błędem było podanie brzmienia przepisu z innej daty jako obowiązującego (18 i 17 odpowiedzi). Przykładem jest pytanie o próg wykroczenia przeciwko mieniu, sugerujące, że próg nadal zależy od płacy minimalnej. Tymczasem od 2018 r. jest to kwota stała, początkowo 500 zł, a od 1 października 2023 r. 800 zł (art. 119 § 1 k.w.). GPT-5.6 Terra bez narzędzi podał prawidłową kwotę, choć pomylił historię zmian progu, a z dostępem do wyszukiwania odpowiedział, że próg wynosi 1 201,50 zł, czyli jedną czwartą płacy minimalnej na 2026 r. Model odtworzył dawną regułę mimo dostępu do sieci, a zapis jego wyszukiwań pokazuje, że szukał potwierdzenia przesłanki z pytania, zanim otworzył tekst kodeksu.
Dla praktyka oba rodzaje błędów mają wspólną konsekwencję: nie wyłapie ich sprawdzenie, czy artykuł o danym numerze istnieje. Trzeba otworzyć tekst aktu i przeczytać przepis w brzmieniu właściwym dla ocenianego zdarzenia albo czynności procesowej, z uwzględnieniem przepisów przejściowych.
Co zmienia dostęp do wyszukiwania
W badanej serii dostęp do wyszukiwania poprawił wyniki łączne, choć nie u każdego modelu. Najwyraźniejsza różnica dotyczyła pytania o doręczenia osobie fizycznej przez Portal Informacyjny, gdzie odpowiedź jeszcze w maju 2026 r. byłaby inna: od 1 czerwca 2026 r. art. 131¹ᵃ § 1 k.p.c. obejmuje także stronę, która wybrała doręczenia przez portal (w razie niemożności doręczenia przez system teleinformatyczny, po złożeniu oświadczenia, o którym mowa w § 1¹). Poprawnie ugruntowanych odpowiedzi było tu 0 na 8 bez narzędzi i 4 na 8 z wyszukiwaniem.
Przykład z progiem wykroczenia pokazuje jednak, że model z dostępem do sieci może wciąż oprzeć się na nieaktualnej regule, a u jednego z modeli (Gemini 4 Argon) liczba odpowiedzi poprawnie ugruntowanych z wyszukiwaniem spadła z 2 do 1. Warto też pamiętać, że wariant z wyszukiwaniem był w badaniu droższy, liczony według cenników API.
Trafne „tak” na złej podstawie
Pytanie o zasadnicze powody rozstrzygnięcia brzmiało: czy po ich wskazaniu przez sąd można złożyć wniosek o uzasadnienie. Według klucza wskazanie zasadniczych powodów (art. 357 § 5 k.p.c.) nie zastępuje uzasadnienia, więc jeżeli postanowienie podlega zaskarżeniu, strona może żądać jego uzasadnienia na zasadach art. 357 § 1 albo § 2¹ k.p.c. Claude Haiku 5.5 bez narzędzi odpowiedział „tak”, ale całą odpowiedź oparł na przepisach o wyroku i apelacji.
Gdyby oceniać tylko kierunek odpowiedzi, uznalibyśmy ją za prawidłową. W piśmie taka odpowiedź może jednak skłonić do wskazania błędnej podstawy prawnej albo niewłaściwego środka zaskarżenia, dlatego przed jej użyciem trzeba sprawdzić, czy model w ogóle rozpoznał rodzaj orzeczenia, o które pytano.
Jak prawnik powinien sprawdzać odpowiedź modelu AI
Z tych przykładów wynika kilka czynności kontrolnych, które warto wykonać, zanim odpowiedź modelu trafi do pisma albo do klienta:
- Przeczytaj treść każdego powołanego przepisu, a nie tylko sprawdź, czy istnieje.
- Ustal brzmienie właściwe dla daty, której dotyczy sprawa, z uwzględnieniem nowelizacji i przepisów przejściowych.
- Zadawaj pytanie neutralnie i osobno poleć modelowi sprawdzenie założeń, bo w pytaniach z pułapką modele często przyjmowały błędną przesłankę (benchmark nie mierzył jednak skuteczności takiego przeformułowania).
- Nie traktuj wyszukiwania jako weryfikacji — model z dostępem do sieci popełniał mniej błędów, ale wciąż się mylił.
- Oceniaj podstawę prawną, a nie tylko konkluzję, bo trafny wniosek nie usuwa ryzyka wynikającego z błędnego uzasadnienia.
Pierwsze dwie czynności można częściowo zautomatyzować. Nasze otwarte narzędzie legal-cite-pl pobiera tekst przepisu ze źródła urzędowego, choć ocena, czy przepis ma zastosowanie i jak go wykładać, pozostaje zadaniem prawnika.
Pełne wyniki benchmarku i dane
Na LawBenchmark.pl publikujemy wszystko, co stoi za liczbami: metodologię, dziesięć pytań z kluczami i wynikami każdego modelu, raport PDF oraz karty oceny wszystkich 160 odpowiedzi. Dane są też dostępne jako zbiór na Hugging Face i w repozytorium na GitHubie, razem ze skryptami, które odtwarzają każdą tabelę raportu. Szersze uzasadnienie przyjętej miary zawiera nasz artykuł metodologiczny (w języku angielskim).
Kolejne serie pytań są w przygotowaniu. Jeśli chcesz zgłosić pytanie z własnej praktyki albo współpracować przy ocenie odpowiedzi, zajrzyj na stronę Dołącz do nas.
Wdrażasz AI w kancelarii lub dziale prawnym?
Pomagamy ustalić, w których czynnościach narzędzia AI mają sens, jak kontrolować ich odpowiedzi i jak uregulować współpracę z dostawcą w umowie.
Umów konsultacjęNajczęściej zadawane pytania
Który model AI najlepiej odpowiadał na pytania z polskiego prawa w Benchmarku 02?
W Benchmarku 02 (10 pytań, stan prawny na 1.10.2026) najwięcej odpowiedzi poprawnie ugruntowanych uzyskały GPT-6.1 Sol i GPT-6 Astra, po 6–7 na 10. Badanie obejmowało jedną serię odpowiedzi i nie ustala rankingu modeli, a różnica jednej czy dwóch odpowiedzi nie przesądza o kolejności.
Jak często modele AI mylą się co do przepisów w odpowiedziach prawnych?
W Benchmarku 02 błędne twierdzenie o przepisie lub orzeczeniu wystąpiło w 51 z 80 odpowiedzi bez narzędzi i w 40 z 80 z wyszukiwaniem. Zmyślone źródła były rzadkie (4 na 80); najczęściej model przypisywał istniejącemu przepisowi treść, której w nim nie ma.
Czy dostęp do wyszukiwania w internecie poprawia odpowiedzi AI w polskim prawie?
W Benchmarku 02 poprawił wyniki łączne: poprawnie ugruntowanych odpowiedzi było 27 zamiast 19 na 80, ale nie u każdego modelu. Wyników nie można automatycznie przenosić na aplikacje i produkty korzystające z tych modeli, a podstawę prawną i tak trzeba sprawdzić w źródle urzędowym.
Co oznacza odpowiedź „poprawnie ugruntowana”?
To odpowiedź, która zawiera wszystkie istotne elementy wskazane w kluczu, nie ma wykrytego błędu co do źródła prawa i ma co najmniej jedno powołanie potwierdzone przez oceniającego w źródle urzędowym. Sam brak halucynacji nie wystarcza.
Gdzie można pobrać dane z badania?
Pytania, klucze, odpowiedzi modeli, karty oceny i oceny sędziów-modeli są dostępne na LawBenchmark.pl, na Hugging Face i na GitHubie. Materiał własny autorów udostępniono na licencji CC BY 4.0, a kod na licencji MIT.
Modele AI a polskie prawo: wnioski z Benchmarku 02
160 odpowiedzi AI na pytania z polskiego prawa. Adam Piotrowski omawia błędy modeli, wpływ wyszukiwania i wnioski dla praktyki. Zobacz Benchmark 02.
Podcast LegalTech Talk: jak AI zmienia warsztat prawnika
Adam Piotrowski z KTZR w 7. odcinku podcastu LegalTech Talk (C.H.Beck): skille AI, ograniczenia modeli, klienci z AI i praca prawnika jako proces.