Halucynacje AI w prawie: nie chodzi już o zmyślone wyroki
W skrócie: Głośne liczby mówiące, że narzędzia sztucznej inteligencji do researchu prawnego halucynują w 17–33% przypadków, nie mierzą jednak głównie zmyślonych wyroków. Mierzą ogólny wskaźnik błędu, w którym mieszczą się zwykłe pomyłki w rozumowaniu na w pełni autentycznym materiale. Dla praktyka są to dwa jakościowo różne ryzyka, bo zmyślone źródło wyłapie każdy, kto sprawdzi, czy sprawa istnieje, a błędnie zrozumiany wyrok wymaga już merytorycznej oceny prawnej.
Aktualizacja — 1 listopada 2026 r. Ten wpis omawia badania zagraniczne. Wyniki naszego badania na polskim prawie (8 modeli, 160 odpowiedzi) omawiamy we wpisie Modele AI a polskie prawo: wnioski z Benchmarku 02.
W tym artykule dowiesz się:
- czym różnią się trzy rodzaje halucynacji i który z nich ma znaczenie w prawie,
- co dokładnie oznacza, że odpowiedź jest „osadzona w źródłach", i dlaczego w prawie znaczy to co innego niż w informatyce,
- czym RAG jest naprawdę, a czym nie jest, mimo że bywa tak sprzedawany,
- gdzie konkretnie zawodzą Lexis+ AI, Westlaw i Ask Practical Law AI, z liczbami z badania,
- dlaczego medialne 17–33% mierzy coś innego, niż sugeruje słowo „halucynacja",
- co z tego wynika dla polskiej praktyki, z orzeczeniami sądów odwoławczych na czele.
Zagranicznej literatury o AI w prawie jest sporo, polskiej praktycznie nie ma. Konieczne jest zatem sięgnięcie po pozycje anglosaskie, z zastrzeżeniem, które warto zrobić od razu: duża część problemów jest „panaprawna" i dotyczy prawa na poziomie meta, niezależnie od jurysdykcji. Badania są na wczesnym etapie, bo i samo zagadnienie jest młode, choć analiza nie zaczyna się od zera: prace o uczeniu maszynowym w prawie mają źródła w latach 70. i 80.
Artykuł „Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools" (Journal of Empirical Legal Studies 2025, t. 22, z. 2, s. 216–242) to jedna z pierwszych pozycji, która poważnie podeszła do halucynacji w prawie i praktycznego zastosowania RAG. Badanie objęło modele i narzędzia dostępne w latach 2023–2024: GPT-4, Lexis+ AI, Westlaw AI-Assisted Research oraz Ask Practical Law AI.
Główna teza, że RAG nie eliminuje halucynacji, a jedynie zmniejsza ich poziom, nie jest z perspektywy 2026 r. zjawiskowa. Wyniki poszczególnych narzędzi też traktuję jako materiał historyczny, bo ich dzisiejsze możliwości są daleko z przodu; przytaczam je niżej, bo pokazują rozkład typów błędu, a ten okazuje się trwalszy niż same wskaźniki. Największą wartość widzę natomiast w warstwie definicji, które zostały wyprowadzone zgrabnie i trafnie.
Trzy rodzaje halucynacji
Autorzy budują rozróżnienie na trójpodziale zaproponowanym wcześniej w pracy Large Legal Fictions (Dahl, Magesh, Suzgun, Ho, Journal of Legal Analysis 2024). Model może:
- niewłaściwie odwzorowywać dane, na których został wytrenowany (unfaithful to its training data),
- błędnie wykonać zapytanie użytkownika (unfaithful to its prompt input),
- podawać błędne „fakty" o świecie (unfaithful to the true facts of the world).
W prawie najważniejsza jest kategoria trzecia i to ją badano, w dwóch wymiarach.
Poprawność (correctness). Odpowiedź jest poprawna, gdy prawidłowo odpowiada na zadane pytanie. Jako przykład odpowiedzi częściowo poprawnej podano taką, która zawiera prawidłowe informacje, ale nie odpowiada w całości na pytanie.
Osadzenie w źródłach (groundedness). Czy odpowiedź prawidłowo odwołuje się do prawidłowych, w tym prawdziwych, źródeł prawnych. Odpowiedź jest nieosadzona (ungrounded), gdy kluczowe twierdzenia nie mają cytowań, i błędnie osadzona (misgrounded), gdy cytowania są, ale źródło zostało błędnie zinterpretowane albo jest nieadekwatne.
Istotne jest zastrzeżenie proceduralne, łatwe do przeoczenia: w oryginale stoi wprost, że groundedness is only applicable for correct responses. Osadzenie ocenia się wyłącznie wobec odpowiedzi już uznanych za poprawne merytorycznie. Jeśli odpowiedź jest błędna, kwestii osadzenia nie rozpatruje się dalej. Mamy tu sekwencję, a nie dwie niezależne, równoległe osie.
Pojęcie „osadzenia" znaczy przy tym w prawie co innego niż w informatyce. Prawidłowo osadzona odpowiedź to nie odpowiedź oparta na jakimkolwiek istniejącym źródle, ale na takim źródle prawa, które jest prawidłowe i obowiązujące w danej dacie. Konsekwencje tego rozróżnienia widać najlepiej przy obowiązkach wynikających z AI Act, gdzie stan prawny zmienia się etapami.
RAG niczego modelu nie uczy
Tłumaczenie w poważnym artykule naukowym, czym jest RAG, wydawało mi się początkowo zbędne. Potem zdałem sobie sprawę, że większość osób rozumie RAG jako „AI na własnych źródłach", co sugeruje, że model został na tych źródłach douczony. Tak nie jest.
RAG w momencie zapytania wyszukuje pasujące fragmenty dokumentów i dokleja je do polecenia użytkownika, a model czyta całość łącznie. Ma więc dwa ogniwa: wyszukanie (retrieval) i wykorzystanie znalezionego (generation). Zmienia to, co model dostaje na wejściu, ale nie to, jak generuje odpowiedź. Dobre wyszukanie nie gwarantuje zatem dobrej odpowiedzi.
Autorzy zwracają uwagę na problemy w obu ogniwach. Wyzwaniem jest już samo ustalenie, jakich informacji RAG powinien szukać, żeby były istotne dla zadania. Wyszukiwanie opiera się na podobieństwie semantycznym, więc może zwracać dokumenty jedynie pozornie istotne. Model bywa też bardziej ufny wobec danych treningowych niż wobec dokumentów z retrievalu.
Zgadzam się również z twierdzeniem, że działanie RAG w prawie nie może sprowadzać się do podsumowania dokumentów, bo dokumenty prawne są pisane przez prawników dla prawników. Skoro dobry research prawny wykonany przez człowieka wymaga wiedzy i doświadczenia, prosta wyszukiwarka semantyczna nie może w prawie dobrze działać.
Warto przy tym zachować proporcje, bo łatwo z tej krytyki wyciągnąć wniosek zbyt daleko idący. Wcześniejsze badanie tego samego zespołu pokazało, że modele ogólnego przeznaczenia, pytane o konkretne i sprawdzalne okoliczności rzeczywistych spraw, halucynują od 58% przypadków przy ChatGPT-4 do 88% przy Llamie 2. Zestawienie tych liczb z 17–33% dla narzędzi opartych na RAG pokazuje, że sama technika działa i to bardzo wyraźnie. Spór nie dotyczy więc tego, czy RAG pomaga, ale tego, czy pozwala zejść z poziomu „często się myli" na poziom, przy którym prawnik może zdjąć rękę z kierownicy.
Ile te narzędzia realnie trafiają
Benchmark objął 202 zapytania zbudowane tak, by sprawdzać odporność na halucynacje, a nie ogólną wiedzę prawniczą. Wyniki rozkładają się nierówno.
| Narzędzie | Odpowiedzi poprawne i osadzone | Odpowiedzi niepełne |
|---|---|---|
| Lexis+ AI | 65% | 18% |
| Westlaw AI-Assisted Research | 41% | 25% |
| Ask Practical Law AI | 19% | 62% |
Druga kolumna jest tu równie istotna jak pierwsza, a bywa pomijana. „Niepełna" oznacza odmowę odpowiedzi albo odpowiedź bez osadzenia w źródłach. Ask Practical Law AI odmawia lub odpowiada bez źródeł w niemal dwóch trzecich zapytań, co z perspektywy użytkownika jest problemem innego rodzaju niż halucynacja: narzędzie nie wprowadza w błąd, ale też nie wykonuje zadania.
Zestawienie obu kolumn prowadzi do wniosku, którego nie widać przy patrzeniu na sam wskaźnik halucynacji. Narzędzie ostrożne wypada dobrze w statystyce błędów właśnie dlatego, że często milczy, a narzędzie, które zawsze odpowiada, kupuje kompletność ceną ryzyka. Ocena przydatności wymaga więc spojrzenia na oba wskaźniki naraz.
Co badanie uznaje za halucynację
Za halucynację uznano odpowiedź, która jest nieprawidłowa (incorrect) albo błędnie osadzona (misgrounded).
Wbrew mojemu pierwszemu wrażeniu z lektury te kategorie nie zachodzą na siebie. Misgrounded z definicji zakłada, że treść odpowiedzi jest merytorycznie poprawna, tylko cytowane źródło jej nie potwierdza albo jest nieadekwatne. Incorrect dotyczy odpowiedzi merytorycznie błędnej, niezależnie od cytowań.
Ciekawa jest refleksja, że błędne rozumienie prawidłowego źródła może prowadzić do poważniejszych skutków niż odpowiedź oparta na źródle sfabrykowanym, bo taki błąd trudniej wyłapać.
Przyczyny halucynacji: gdzie dokładnie zawodzą narzędzia
Autorzy proponują typologię przyczyn z częstością występowania dla trzech badanych narzędzi. Kategorie nie sumują się do jedności, bo nie są rozłączne — jedna halucynacja może mieć kilka przyczyn.
| Przyczyna | Lexis+ AI | Westlaw AI-AR | Ask Practical Law AI |
|---|---|---|---|
| Naive Retrieval (błędne wyszukanie źródeł) | 0,47 | 0,20 | 0,34 |
| Inapplicable Authority (nieadekwatny autorytet prawny) | 0,38 | 0,23 | 0,34 |
| Reasoning Error (błąd rozumowania) | 0,28 | 0,61 | 0,49 |
| Sycophancy (uleganie fałszywej przesłance użytkownika) | 0,06 | 0,00 | 0,03 |
Źródło: tabela 6 w cytowanym artykule.
Widać tu wprost oba ogniwa RAG: pierwsza kategoria to awaria wyszukania, a trzy pozostałe to awarie wykorzystania znalezionego.
Rozkład jest przy tym wymowny. Lexis zawodzi przede wszystkim na wyszukaniu (0,47), a Westlaw, który halucynuje najczęściej ze wszystkich badanych narzędzi, zawodzi przede wszystkim na rozumowaniu (0,61, czyli ponad dwukrotnie częściej niż Lexis). Dla porządku: teza z abstraktu, że Westlaw halucynuje „niemal dwukrotnie częściej", dotyczy halucynacji ogółem, nie samych błędów rozumowania.
Nawet gdyby model ustrzegł się błędów na wcześniejszych etapach, na końcu i tak może dojść do błędnych wniosków, czyli przekładając na nasz system, dokonać błędnej subsumpcji.
Definicja halucynacji jest przyjęta zbyt szeroko
Tu mam do artykułu zastrzeżenie. Skoro sama kategoria incorrect kwalifikuje odpowiedź jako halucynację niezależnie od tego, czy cokolwiek zostało zmyślone, pojęcie obejmuje znacznie więcej niż potoczne rozumienie halucynacji jako fabrykacji: zmyślonego wyroku, wymyślonego przepisu czy przypisania fałszywej tezy istniejącemu orzeczeniu.
Autorzy tłumaczą to poszerzenie przykładem narzędzia, które zawsze cytuje Brown v. Board of Education niezależnie od pytania — przy wąskiej definicji byłoby formalnie „hallucination-free". Uzasadnienie rozumiem, ale problemu ono nie rozwiązuje.
W praktyce oznacza to, że cytowane w mediach 17–33% nie mierzy głównie zmyślonych wyroków, tylko ogólny wskaźnik błędu, w którym mieszczą się zwykłe błędy rozumowania na autentycznym materiale oraz cytowanie nieadekwatnego, choć prawdziwie istniejącego autorytetu.
Rozróżnienie ma znaczenie praktyczne, bo z punktu widzenia odpowiedzialności zawodowej są to jakościowo różne ryzyka.
Zmyślone źródło da się wyłapać samą weryfikacją, czy sprawa w ogóle istnieje. Klasycznym przykładem jest sprawa Mata v. Avianca, Inc. (sygn. 1:22-cv-01461, Sąd Okręgowy dla Południowego Dystryktu Nowego Jorku), w której pełnomocnik powoda złożył pismo powołujące sześć nieistniejących precedensów wygenerowanych przez ChatGPT. Postanowieniem z 22 czerwca 2023 r. sąd nałożył na pełnomocników i ich kancelarię karę w wysokości 5000 dolarów. Cały mechanizm wykryto najprostszym możliwym sposobem: strona przeciwna nie znalazła powołanych orzeczeń.
Błąd rozumowania na autentycznym materiale wymaga już merytorycznej oceny prawnej, żeby go w ogóle zauważyć. Dobrze pokazuje to sprawa Moffatt v. Air Canada (2024 BCCRT 149), w której chatbot przewoźnika błędnie przedstawił jego własną politykę taryf żałobnych. Trybunał — Civil Resolution Tribunal w Kolumbii Brytyjskiej — uznał, że linia lotnicza nie dochowała należytej staranności przy zapewnieniu poprawności chatbota, i zasądził odszkodowanie z tytułu negligent misrepresentation w wysokości 650,88 CAD, odpowiadającej różnicy w cenie biletu.
Co z tego wynika dla polskiego rynku
Nie chciałbym, żeby ta wypowiedź ograniczyła się do streszczenia, więc kilka refleksji o wnioskach dla naszego rynku AI dla prawników.
RAG nie jest lekiem na halucynacje. Model wciąż może błędnie rozumieć orzeczenie i mylić stanowiska stron. Widać to szczególnie przy orzeczeniach sądów odwoławczych, gdzie modele bardzo często mylą ustalenia sądu I instancji, przywołane w uzasadnieniu, z rzeczywistymi ustaleniami sądu II instancji. Dla polskiej praktyki to problem poważniejszy niż w systemie common law, bo nasze uzasadnienia z natury referują cudze stanowiska: strony, sądu niższej instancji, biegłego. Model, który tego nie rozróżnia, potrafi przypisać sądowi pogląd, który sąd właśnie odrzucił.
Dobry retrieval wymaga dodatkowej warstwy sprawdzenia. W praktyce warto dołożyć warstwę audytu, która oceni nie tylko to, czy orzeczenie zostało znalezione, ale czy jest przydatne i czy model je zrozumiał. Dobrze wykonany retrieval jest początkiem, nie końcem. Tak właśnie zbudowaliśmy własne narzędzia prawnicze, w których weryfikacja cytowania jest osobnym krokiem, a nie efektem ubocznym generowania.
Definicje dostawców bywają marketingowe. Duża część dostawców różnie definiuje halucynacje i chętnie powołuje się na benchmarki zbudowane pod siebie. Autorzy cytują tu deklarację LexisNexis, według której narzędzie dostarcza „100% hallucination-free linked legal citations", i zestawiają ją z własnym pomiarem, w którym to samo narzędzie odpowiada poprawnie i z prawidłowym osadzeniem w 65% zapytań. Rozbieżność bierze się głównie z tego, co która strona liczy. Skoro nawet definicja z rzetelnego artykułu naukowego budzi dyskusję, o ile większej ostrożności wymagają definicje z materiałów sprzedażowych. Praktyczne pytanie do dostawcy brzmi: co dokładnie liczycie jako halucynację i czy w tej liczbie mieszczą się błędy rozumowania na prawdziwych źródłach. Systematyczny przegląd tego, co narzędzia prawnicze obiecują, a co da się zweryfikować, daje praca Promises and Pitfalls of Artificial Intelligence for Legal Applications (Kapoor, Henderson, Narayanan 2024).
W Polsce dochodzi problem dostępu do przepisu na daną datę. Każdy, kto próbował zbudować narzędzie prawidłowo łączące teksty jednolite z nowelizacjami, wie, ile to pracy. Bez tego warstwa „osadzenia" w rozumieniu prawniczym, czyli w źródle obowiązującym w konkretnym dniu, pozostaje niepełna — a właśnie ona decyduje o użyteczności odpowiedzi w sprawie, w której liczy się stan prawny sprzed dwóch lat.
Skala błędu zależy od tego, do czego narzędzia używamy. Inne ryzyko niesie wykorzystanie modelu do wstępnego rozpoznania tematu, a inne do przygotowania pisma procesowego. Przy pierwszym zastosowaniu nawet źle zinterpretowany wyrok, o ile nie został zmyślony, bywa wartościowym punktem wyjścia do researchu. Przy drugim ten sam błąd trafia do akt. Praktyczne konsekwencje tego rozróżnienia opisaliśmy szerzej przy okazji wdrożeń w kancelariach.
Najważniejszy wniosek z całej lektury brzmi więc tak: dzisiaj problemem nie są już zmyślone wyroki, tylko źle zrozumiane. Weryfikacja istnienia sprawy przestaje wystarczać, a zaczyna być potrzebna weryfikacja tego, co w niej rzeczywiście napisano.
Co realnie sprawdzać w odpowiedzi narzędzia
Powyższy wniosek przekłada się na konkretne czynności. Sprawdzenie, czy orzeczenie istnieje, zostaje, ale przestaje być ostatnim krokiem.
- Czy powołane orzeczenie faktycznie istnieje i czy sygnatura zgadza się z sądem oraz datą. Ten krok wyłapuje wyłącznie fabrykacje, czyli mniejszość dzisiejszych błędów.
- Czy teza przypisana orzeczeniu jest tezą sądu, a nie referowanym w uzasadnieniu stanowiskiem strony, biegłego albo sądu niższej instancji. Przy wyrokach odwoławczych to najczęstsze źródło błędu.
- Czy przepis obowiązywał w dacie istotnej dla sprawy. Model operuje zwykle brzmieniem aktualnym, a sprawa bywa oceniana według stanu sprzed nowelizacji.
- Czy orzeczenie nie zostało zmienione albo przełamane późniejszą uchwałą lub linią orzeczniczą. Model nie ma wbudowanego odpowiednika sprawdzenia aktualności.
- Czy odpowiedź odpowiada na całe pytanie. Odpowiedź częściowo poprawna, pomijająca istotny element, jest w cytowanym badaniu klasyfikowana jako błędna, i słusznie.
- Czy narzędzie nie przytaknęło błędnej przesłance zawartej w pytaniu. Zjawisko to, opisane osobno w pracy Towards Understanding Sycophancy in Language Models (Sharma i in. 2023), polega na skłonności modelu do zgadzania się z użytkownikiem nawet wtedy, gdy użytkownik się myli. W badaniu odpowiada za 6% halucynacji Lexis+ AI, a dla pozostałych narzędzi jest marginalne.
Pierwszy punkt z tej listy wykona każdy. Pozostałe wymagają prawnika, który zna sprawę, i tego żadne narzędzie na razie nie zastępuje.
Czego nauczyło nas budowanie własnego narzędzia
Trzeci punkt powyższej listy, czyli brzmienie przepisu w danej dacie, dało się częściowo zautomatyzować. Zbudowaliśmy legal-cite-pl, serwer MCP, który zamiast polegać na pamięci modelu pobiera dosłowne brzmienie powołanego artykułu z oficjalnego rejestru: api.sejm.gov.pl dla prawa polskiego i EUR-Lex dla unijnego. Narzędzie zwraca wyłącznie powołany przepis w tekście jednolitym, w brzmieniu obowiązującym, a nie całą ustawę. Jest otwarte, więc każdy może je sprawdzić i użyć.
Z budowy tego narzędzia płyną dwie obserwacje, których nie znalazłem w literaturze, a które dobrze pokazują, dlaczego osadzenie w źródle jest trudniejsze, niż wygląda.
Oficjalne API potrafi oddać nie to, o co się prosi. Punkt /text.html w API Sejmu zwraca tekst pierwotny, czyli w brzmieniu z dnia ogłoszenia, a nie tekst jednolity. Przy ustawie nowelizowanej kilkanaście razy ta różnica przesądza o wyniku, bo kwoty, terminy i całe jednostki redakcyjne bywają inne. Prawidłowe pobranie wymaga sięgnięcia po tekst ujednolicony, oznaczony osobnym typem.
Fałszywy negatyw wygląda dokładnie jak błąd merytoryczny. Ten sam plik zawiera na końcu blok nawigacyjny, w którym każdy artykuł występuje jako pozycja spisu treści. Wyszukiwanie po numerze artykułu trafia w ten spis, a nie w przepis, i zwraca „nie znalazłem" dla artykułów, które w ustawie są. Weryfikacja daje wtedy wynik negatywny, który wygląda identycznie jak błąd sprawdzanego tekstu — i kusi, by poprawiać treść, która była poprawna.
Praktyczny wniosek jest taki, że warstwa weryfikacji sama wymaga weryfikacji. Przy każdym sprawdzeniu opartym na źródle zewnętrznym warto zacząć od kontroli pozytywnej, czyli od zapytania, na które znamy odpowiedź. Bez tego „nie znalazłem" jest nierozróżnialne od „nie istnieje", a to dwie zupełnie różne informacje.
Źródła
Omawiana publikacja: V. Magesh, F. Surani, M. Dahl, M. Suzgun, C. D. Manning, D. E. Ho, Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, Journal of Empirical Legal Studies 2025, t. 22, z. 2, s. 216–242. Autorzy reprezentują Stanford University (Regulation, Evaluation and Governance Lab) oraz Yale University. Tekst jest dostępny w otwartym dostępie.
Dla czytelnika, który chciałby pójść dalej, warte uwagi są trzy pozycje przywoływane w tej publikacji:
- M. Dahl, V. Magesh, M. Suzgun, D. E. Ho, Large Legal Fictions: Profiling Legal Hallucinations in Large Language Models, Journal of Legal Analysis 2024, t. 16, nr 1, s. 64–93 — źródło trójpodziału halucynacji oraz wskaźników dla modeli ogólnego przeznaczenia (58% dla ChatGPT-4, 88% dla Llamy 2).
- S. Kapoor, P. Henderson, A. Narayanan, Promises and Pitfalls of Artificial Intelligence for Legal Applications, Journal of Cross-Disciplinary Research in Computational Law 2024, t. 2, nr 2 — przegląd rozbieżności między obietnicami dostawców a możliwą do zweryfikowania rzeczywistością.
- N. Guha, J. Nyarko, D. E. Ho i in., LegalBench: A Collaboratively Built Benchmark for Measuring Legal Reasoning in Large Language Models, 2023 — najszerzej stosowany zestaw testów rozumowania prawniczego, przydatny przy ocenie benchmarków, na które powołują się dostawcy.
Wszystkie liczby przytoczone w tym tekście pochodzą z omawianej publikacji i zostały sprawdzone w jej pełnej wersji, a nie w streszczeniach.
Najczęściej zadawane pytania
Czy RAG eliminuje halucynacje AI?
Nie. RAG zmniejsza ich poziom, ale ich nie eliminuje. Wyszukuje pasujące fragmenty dokumentów i dokleja je do zapytania, zmieniając to, co model dostaje na wejściu, ale nie to, jak generuje odpowiedź. Badanie Stanforda i Yale wykazało, że narzędzia oparte na RAG nadal halucynują w 17–33% przypadków.
Co oznacza, że narzędzie AI halucynuje w 17–33% przypadków?
Mniej, niż sugeruje potoczne rozumienie tego słowa. W cytowanym badaniu za halucynację uznano odpowiedź nieprawidłową merytorycznie albo błędnie osadzoną w źródłach. W tej liczbie mieszczą się więc zwykłe błędy rozumowania na prawdziwych orzeczeniach i cytowanie nieadekwatnego, ale istniejącego autorytetu, a nie tylko zmyślone wyroki.
Czym różni się odpowiedź nieosadzona od błędnie osadzonej?
Odpowiedź nieosadzona (ungrounded) nie zawiera cytowań kluczowych twierdzeń. Odpowiedź błędnie osadzona (misgrounded) cytowania zawiera, ale źródło zostało błędnie zinterpretowane albo jest nieadekwatne. W badaniu osadzenie oceniano wyłącznie wobec odpowiedzi już uznanych za merytorycznie poprawne.
Czy prawnik odpowiada za błąd narzędzia AI?
Korzystanie z narzędzia nie przenosi odpowiedzialności zawodowej na dostawcę. W sprawie Mata v. Avianca konsekwencje poniósł pełnomocnik, który złożył pismo z nieistniejącymi precedensami. Po stronie przedsiębiorcy analogicznie zadziałała sprawa Moffatt v. Air Canada, gdzie za błędną informację chatbota odpowiedziała linia lotnicza, a nie dostawca technologii.
Które narzędzie wypadło najgorzej w badaniu?
Westlaw AI-Assisted Research halucynował najczęściej spośród badanych narzędzi, przy poprawności odpowiedzi na poziomie 42%. Jego dominującą przyczyną błędów było rozumowanie (0,61), a nie wyszukanie źródeł. Zastrzeżenie: badanie obejmowało wersje narzędzi z lat 2023–2024. Tekst ma charakter informacyjny i nie stanowi porady prawnej. Stan na wrzesień 2026 r.
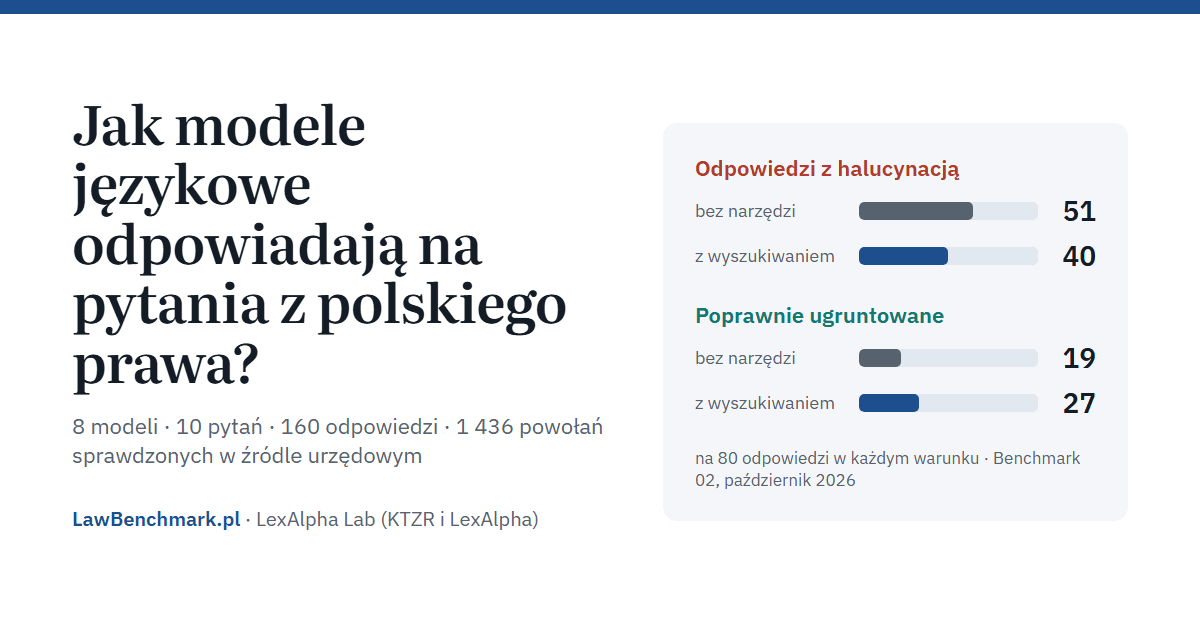
Modele AI a polskie prawo: wnioski z Benchmarku 02
160 odpowiedzi AI na pytania z polskiego prawa. Adam Piotrowski omawia błędy modeli, wpływ wyszukiwania i wnioski dla praktyki. Zobacz Benchmark 02.
Podcast LegalTech Talk: jak AI zmienia warsztat prawnika
Adam Piotrowski z KTZR w 7. odcinku podcastu LegalTech Talk (C.H.Beck): skille AI, ograniczenia modeli, klienci z AI i praca prawnika jako proces.
Świetny tekst. Zastanawiałem się, jak odróżnić halucynacje od błędów w interpretacji, a ten podział bardzo mi pomógł. Czekam na więcej wpisów o RAG.